一、缘起
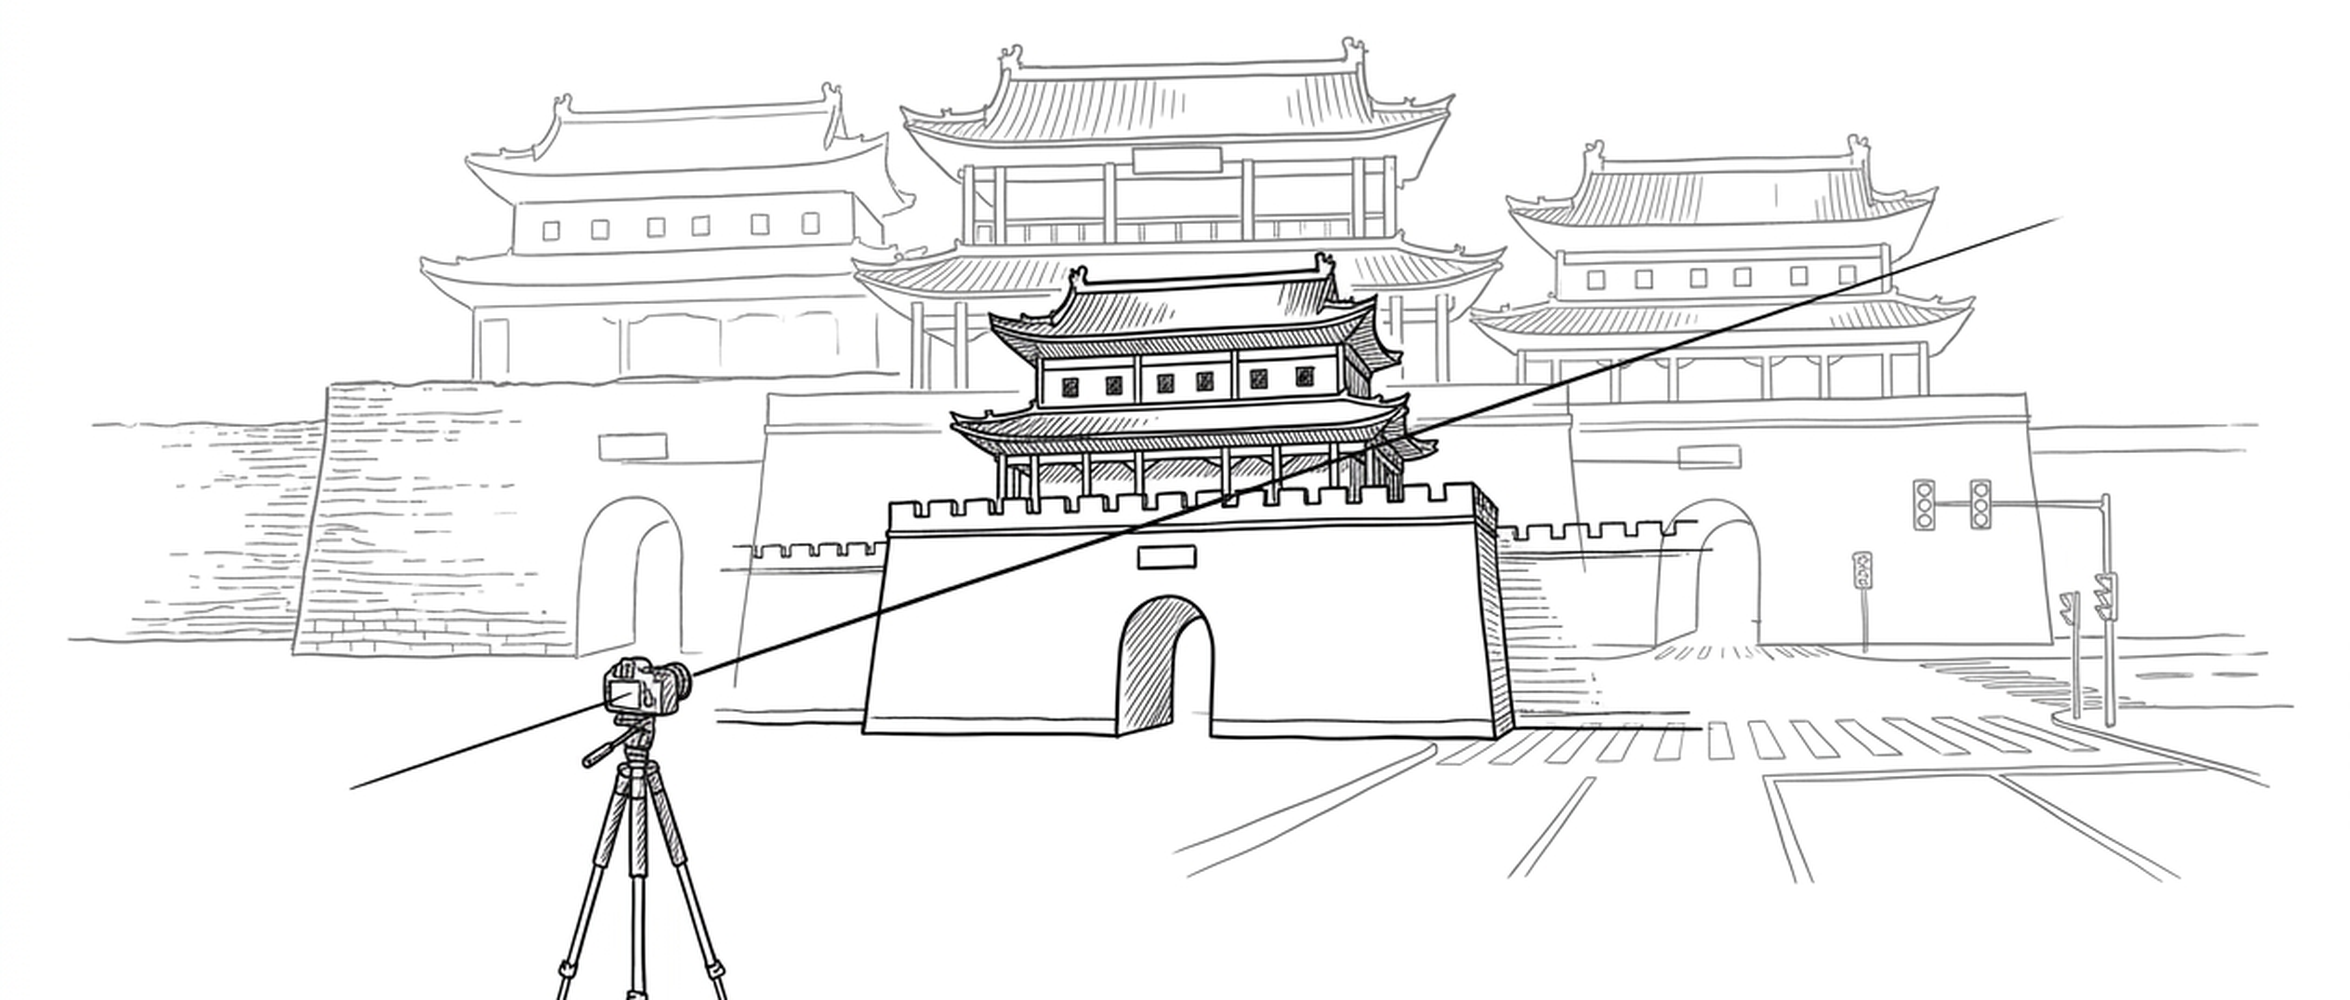
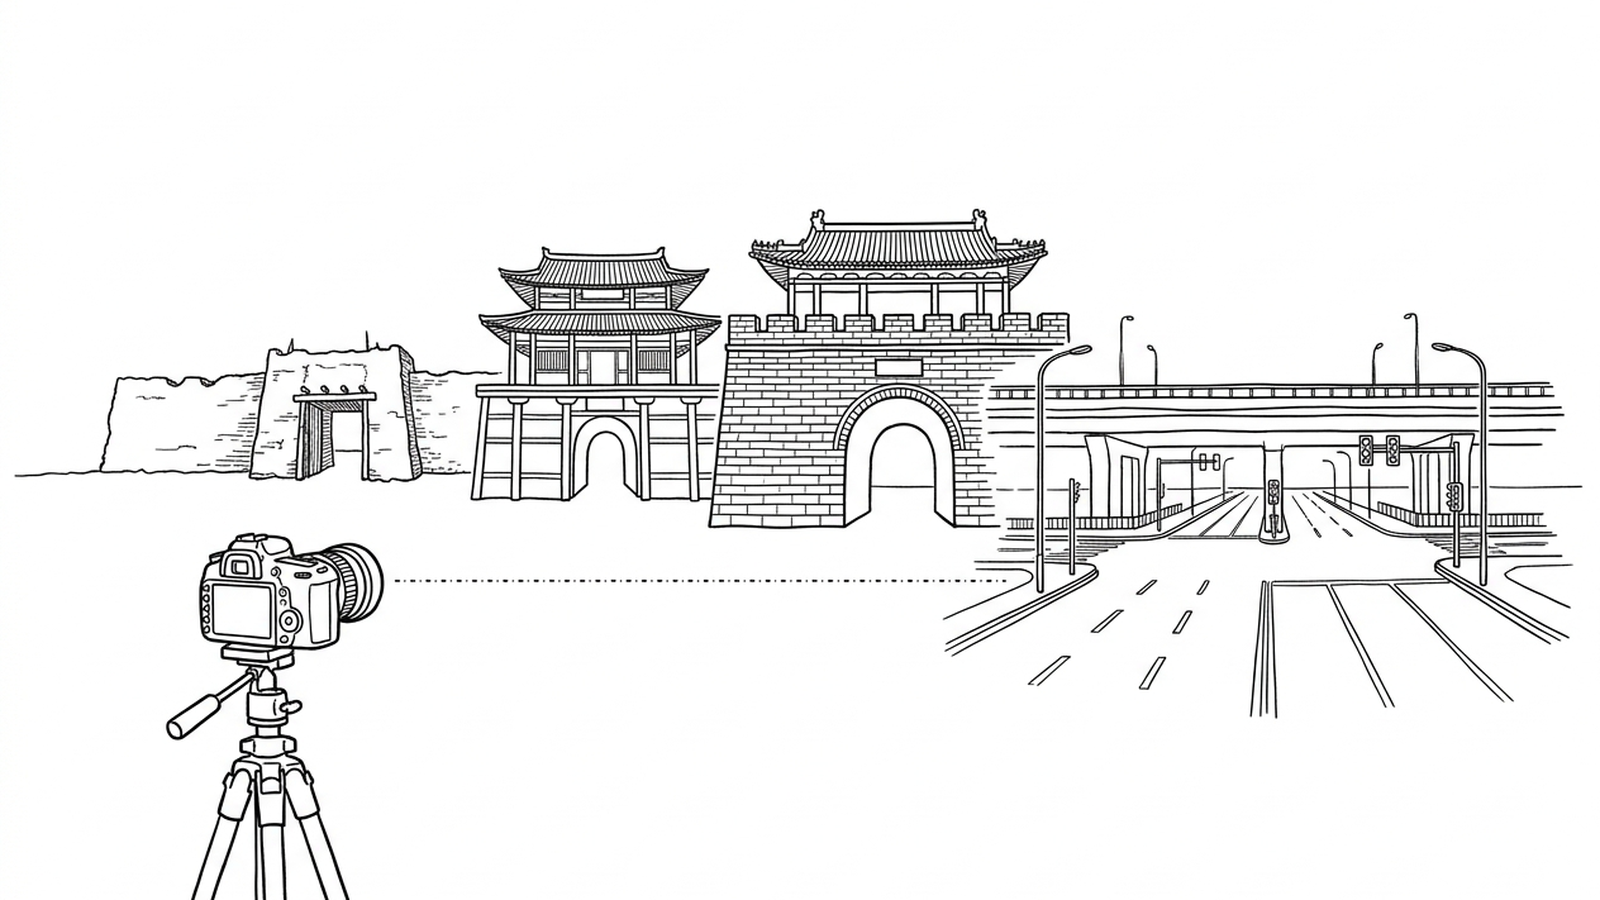
事情的起点很简单。一个朋友看到我在朋友圈发的 AI 生成视频,建议我做一个关于洛阳城门变化的片子——同一座城门,从三千年前的夯土围垣,一路变到 2026 年的城市路口。
这个提议打动我的地方在于它的限制:机位不动,只让时间流过。没有航拍,没有推拉摇移,没有转场特效,只有一座城门和一条路。所有的变化都发生在建筑形制、人的衣着、车马的样式和光线里。这个限制既是美学,也是技术难题——AI 视频最擅长的恰恰是运动,而这部片子要求它克制。
于是有了后来的八分钟。
二、选型:为什么是 L40S
第一个问题是模型。要生成历史场景,又要保持建筑稳定,普通的图生视频模型不够用。最后选的是 MiniMax H3 的 HyperFlow Flash 14B,GGUF 量化版本,Q4_K_M。这个模型的峰值显存大约 30GB,24GB 的卡(4090、3090)跑不动,会直接爆显存。
算家云上能选的卡里,L40S 48GB 是最合适的:显存够,价格每小时 5 元,不算便宜,但比 A100 80GB 现实。租之前我算过一笔账:如果全部生成时间在 8 到 15 小时之间,费用大约 40 到 75 元,加上重试的余量,准备 100 元够了。
2026 年 11 月 13 日 17 点 48 分,容器开始拉镜像;17 点 50 分,容器创建完成,实例进入运行状态。
三、第一次部署:把模型搬进服务器
真正的麻烦从部署开始。
服务器在国内,直连 Hugging Face 和 GitHub 都不稳定,git clone 会挂住,模型文件下到一半断掉。最后的办法是绕:ComfyUI 和两个自定义节点(ComfyUI-GGUF、ComfyUI-HyperFlow-Flash)在本机下载好,打成 tar 包,传到 Hugging Face 的一个 dataset 仓库,服务器再用 hf-mirror.com 拉下来。模型文件也走同样的镜像。
PyTorch 的官方源同样慢,换成阿里云的 cu128 轮子才装完。ComfyUI 的依赖里还有几个前端模板包要求 Python 3.12,而服务器是 3.10,只能从 requirements 里删掉——反正我们只用 API 生成,不用它的网页界面。
还有一个细节:系统盘只有 30GB,而且要随镜像保存。所以 pip 缓存、临时文件、ComfyUI、虚拟环境、模型、渲染结果,全部放到数据盘 /root/sj-tmp。这个决定后来救了几次命。
四、第一次跑通
11 月 13 日 21 点 29 分,56 帧的冒烟测试成功。输出是一段 512×512、24fps、2.33 秒的 mp4,338KB。画面里是一座灰阶的古城门,镜头锁死,云在动,远处有几个人走过。
这说明链路是通的:模型加载、文本编码、VAE 解码、视频封装,全部正常。
接着跑了两条 124 帧的风格测试:现代城门和隋唐定鼎门。两条都成功,各 5.17 秒。到这一步,技术验证结束,剩下的都是内容和审美问题。
五、比例问题
第一条 124 帧的片子出来,比例不对——方形。原因是工作流里写死了 512×512,而关键帧是 16:9。改成 1024×576(16:9,且能被 64 整除)重跑,通过了。
这件事说明一个很朴素的道理:AI 生成里,工作流的参数就是法律。提示词写得再对,分辨率错了,出来就是错的。
六、那个没能跑起来的夜晚
11 月 13 日 22 点 26 分,我说“可以,开始吧”,然后去睡觉了。原计划是让助手在夜里把 16 个时代的批量生成跑完。
结果没有跑起来。
原因有三个,叠在一起:Mac 锁屏后,系统的键盘注入被丢弃;算家云的网页会话掉线;SSH 网关口令认证失败。三条远程通道同时断了,服务器只能空转。
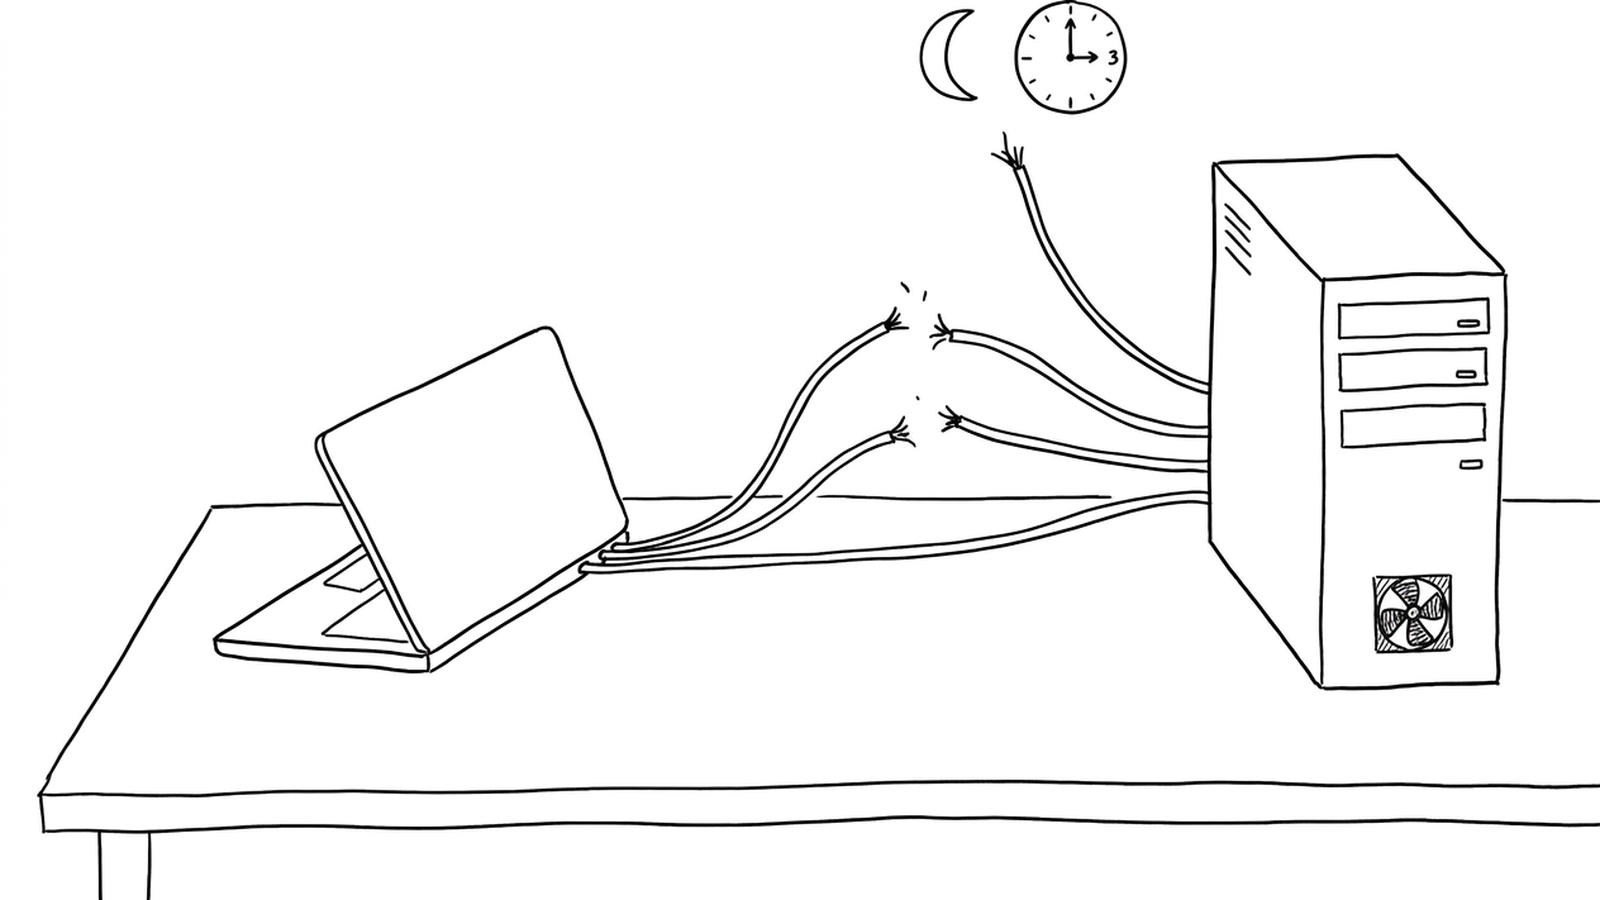
从 22 点半到第二天凌晨 4 点多,五个多小时,每小时 5 元,什么都没干。
这是整个项目里最贵的一课:远程自动化不能只依赖一条通道,也不能假设“夜里没人动,环境就不会变”。锁屏、会话过期、口令失效,任何一个都足以让整晚的计划归零。
七、凌晨的批量
11 月 14 日凌晨 4 点 18 分,人醒了,手动跑了引导脚本。16 条 clip 很快完成,BATCH_SUMMARY ok=16 fail=0。打包、下载、解包、ffprobe 逐条核对:16 条全部是 1024×576、124 帧。
凌晨 4 点 26 分,第一版粗剪出来,82.7 秒。16 个时代硬切拼接,带环境声。这是一版骨架,能看,但离“片子”还差得远。
八、扩到十分钟
第二版的目标是把片子撑到 10 分钟,并且把洛阳的重大历史事件都放进去。
分镜重写成了 41 个镜头、八幕:引子、先秦、秦汉魏晋、北朝、隋唐、宋元明清、近现代、结尾。每一镜都标了字幕入点和文案,事件不切机位,靠同一视轴下的使用方式变化来表达——二里头的夯土、偃师商城的门屋、周公营成周的版筑、平王东迁的车队、东汉的三门道、白马寺的僧侣、蔡伦的纸、张衡的地动仪、熹平石经、董卓焚城、永嘉之乱、孝文帝迁都、龙门石窟、隋营东都、大运河、武周神都、安史之乱、白居易、司马光、二程、福王府、1932 行都、1948 解放、一五工业、1959 年二里头发现、遗址博物馆,最后回到 2026。
为了这些镜头,又生成了 12 张时代关键帧、6 张补充关键帧,前后跑了三轮批量,累计 65 条视频片段。
九、评审与返工
第三版剪出来 7 分 21 秒。随后一份“导演级评审”提了四条硬意见:钟表微距插片破坏了固定机位的神圣感;字幕有 14 处重叠;全片静音;分辨率停在 1024×576。
于是有了 3.1 和 4.0。
3.1 先修字幕和声音:字幕改成零重叠,每行不超过 18 字,时长按字数算,前后留 0.4 秒空白;声音恢复成原生环境声加一层低频 drone,再在时代边界加一声埙式的拨弦。
4.0 按评审的完整方案重做:删掉所有钟表插片,段间用 0.8 秒交叉溶解;加 CAM-01 的 HUD,左上角是机位和坐标,右上角是 REC 和年代;按六个时代做影调,从灰黄夯土到冷调监控;输出 1280×720、CRF 18、AAC 256k 的母版;补跑第四批 10 条差异化镜头,把被合并的段落拆回去。
这一版 7 分 08 秒,加片尾 8 分 02 秒。
十、音乐与片尾
最初用的是程序合成的 drone 和拨弦,后来换成 Kevin MacLeod 的《Eastern Thought》,再换成《Opium》,最后按约定改用了《末代皇帝》的 Main Title Theme。
版权这件事必须说清楚:前两首是 CC BY,可以商用,署名即可;《末代皇帝》原声是有版权的,自己看片、内部放映没问题,公开发布需要授权,否则平台会静音或下架。
片尾做了七张卡:片名、史籍出处、考古与方志、机构与遗产、使用模型、消耗、制作信息。模型清单按真实供应商列:Codex、Omni、OpenCode-Go、Mistral、DeepSeek、Qwen;视频模型是 MiniMax H3 HyperFlow Flash 14B;关键帧是 GPT-Image-2。文本 token 累计 2336 万,其中输入 2325 万、输出 11 万,缓存命中 1866 万。
十一、账本
充值 100 元,结束时剩余 38.34 元,实际花费 61.66 元。
服务器的开关记录是这样的:
- 11 月 13 日 17:50 创建并运行
- 11 月 14 日 04:25 关机(此前约 10 小时 35 分)
- 04:25 到 05:58 关机
- 05:58 开机,07:05 关机(约 1 小时 07 分)
- 07:05 到 08:47 关机
- 08:47 开机,09:11 关机(约 24 分)
累计运行约 12 小时 06 分,按每小时 5 元算,约 60.5 元,和实际扣费基本对得上。
其中效率最低的是第一个晚上:五个多小时空转,约 25 元,没有产出。如果那晚能跑起来,总成本可以压到 35 元左右。
十二、复盘
做对的地方:
一是把大模型跑在租来的 48GB 卡上,而不是硬塞进 24GB,省了反复爆显存的调试时间。二是所有大文件走镜像和 tar 包,不跟不稳定的直连较劲。三是把系统盘和数据盘分开,模型和渲染结果都放在数据盘,关机不丢。四是先做 56 帧冒烟测试,再做 124 帧风格测试,最后才批量——每一步都只增加一个变量。
做得不够的地方:
一是远程通道太单一。网页会话、SSH、键盘注入,三条都断的时候没有任何兜底。二是第一版批量清单没有做“每镜多条差异化素材”,导致后面要补三轮。三是字幕在第一版里是外挂 srt,没有硬烧,直到第三版才补上。四是过夜空转,本质是把“自动化”当成了“无人化”,但自动化也需要有人守夜,或者至少需要一个能自我恢复的通道。
十三、最后
片子最后是 8 分 02 秒,41 个镜头,65 条素材,18 张关键帧,2336 万 token,12 小时 GPU,61.66 元。
它不完美。有些镜头的人物动作仍然有 AI 的痕迹,有些时代的建筑形制只能算“示意”,字幕的节奏在几个段落里还是偏快。但它做到了一件事:让同一个机位,从二里头一直看到 2026 年,中间没有切过镜头。
这大概就是最初那个建议里最有意思的部分——不是“生成一个视频”,而是“让时间在一座城门上流过”。