这篇的配置你其实不用自己敲。把下面这段直接发给你的智能体,让它读一遍本机现状再动手。
1 | 帮我配置 Magpie 的任务路由,按顺序做完,每步报告结果。 |
下面是我按这套流程做出来的结果,也把每一步的坑和取舍写清楚了,可以对着看。
先说 Magpie 是什么。
它是个 Mac 上的小应用,装在菜单栏里,做的事只有一件:把机器上各种 AI 工具的模型选择,收拢到一个地方。Claude Code、Codex、Gemini CLI、OpenCode、Cursor CLI、Copilot CLI,还有我常用的 Hermes,都在它的名单里。我这份装完是 32 个。装完之后,你在任何一个工具里换模型,都只需要在一个界面点一下,不用去翻各自的配置文件。
它同时在本机开一个小网关,默认地址 127.0.0.1:3425。所有客户端都指到这个地址,模型名写成 magpie/xxx。好处是各家厂商的密钥和登录态只在 Magpie 里存一份,客户端那边不再散落一堆 key。
它不重。我磁盘上这个 app 是 51M,主程序 49M。Contents 目录里没有 Frameworks,说明它不是 Electron 套壳,界面用的是系统自带的浏览器内核,所以体积才这么小。它是 Go 写的,MIT 许可,作者 yetone,项目今年 9 月才上线,版本更新很快。
网关同时听得懂几种协议:OpenAI 的 chat completions、Anthropic 的 messages,实测都能直接通。这意味着不管你用的是哪家的客户端,它都能接住。
它还能识别你本机已经登录的账号。比如 Codex、Claude Code 的登录态,可以直接拿来当上游用,不必另外配 key。
上面这些是底座。这篇文章要讲的,是它更进一层的能力:路由组。
问一句简单问题、改一段代码、分析一段复杂逻辑、看一张图片,需要的模型能力并不一样。全交给强模型,额度掉得快;全交给便宜模型,难任务又容易做坏。
以前我的做法是手动切,每换一种活就切一次,切完还得记住切回哪个。
现在这件事交给路由。我给 Hermes 建了一个 task-router,它只认这一个入口:请求进来先判断这是什么任务,再送进对应的模型组。配好之后我没再手工切过。
这套路由带来什么
先说清楚好处,再讲怎么配。
不用再记“哪个模型配哪种活”。 智能体的默认模型只填一个总组名,之后所有请求自动分流。换项目、换会话都不用重新选。
贵模型只在难活上出现。 简单问答和翻译不消耗高推理额度,复杂规划才进深度组。
长上下文有专门的路。 会话聊到二十万 token 时,请求会自动转到能稳定扛住的模型,不会硬塞给小模型。
图片走独立的组。 带图片的请求不会占用文本模型的额度,也不会让纯文本模型去猜图。
首选不可用时组内自动接续。 一个模型报错、限流或暂时下线,按顺序试下一个,不会把错误直接扔回来。
换模型只改一处。 想换看图模型,只动 vision 组,其他三路不受影响。
骨架:一个总组,四个子组
链路压成四层:
Hermes → task-router → 任务组 → 具体模型
四个子组的职责:
| 子组 | 负责什么 | 首选 |
|---|---|---|
| light | 简短问答、翻译、摘要、小改字 | 免费模型 |
| workhorse | 写功能、修问题、重构、常规排障 | 日常主力模型 |
| deep | 架构设计、复杂规划、根因分析、高风险修改 | 高推理档模型 |
| vision | 带图片的任务 | 视觉模型 |
两级选择是刻意分开的。第一级判断这是什么任务,第二级判断这个组里现在谁还能干活。
这样拆的好处很实在:以后换模型只动一个子组,判断逻辑完全不用重写。
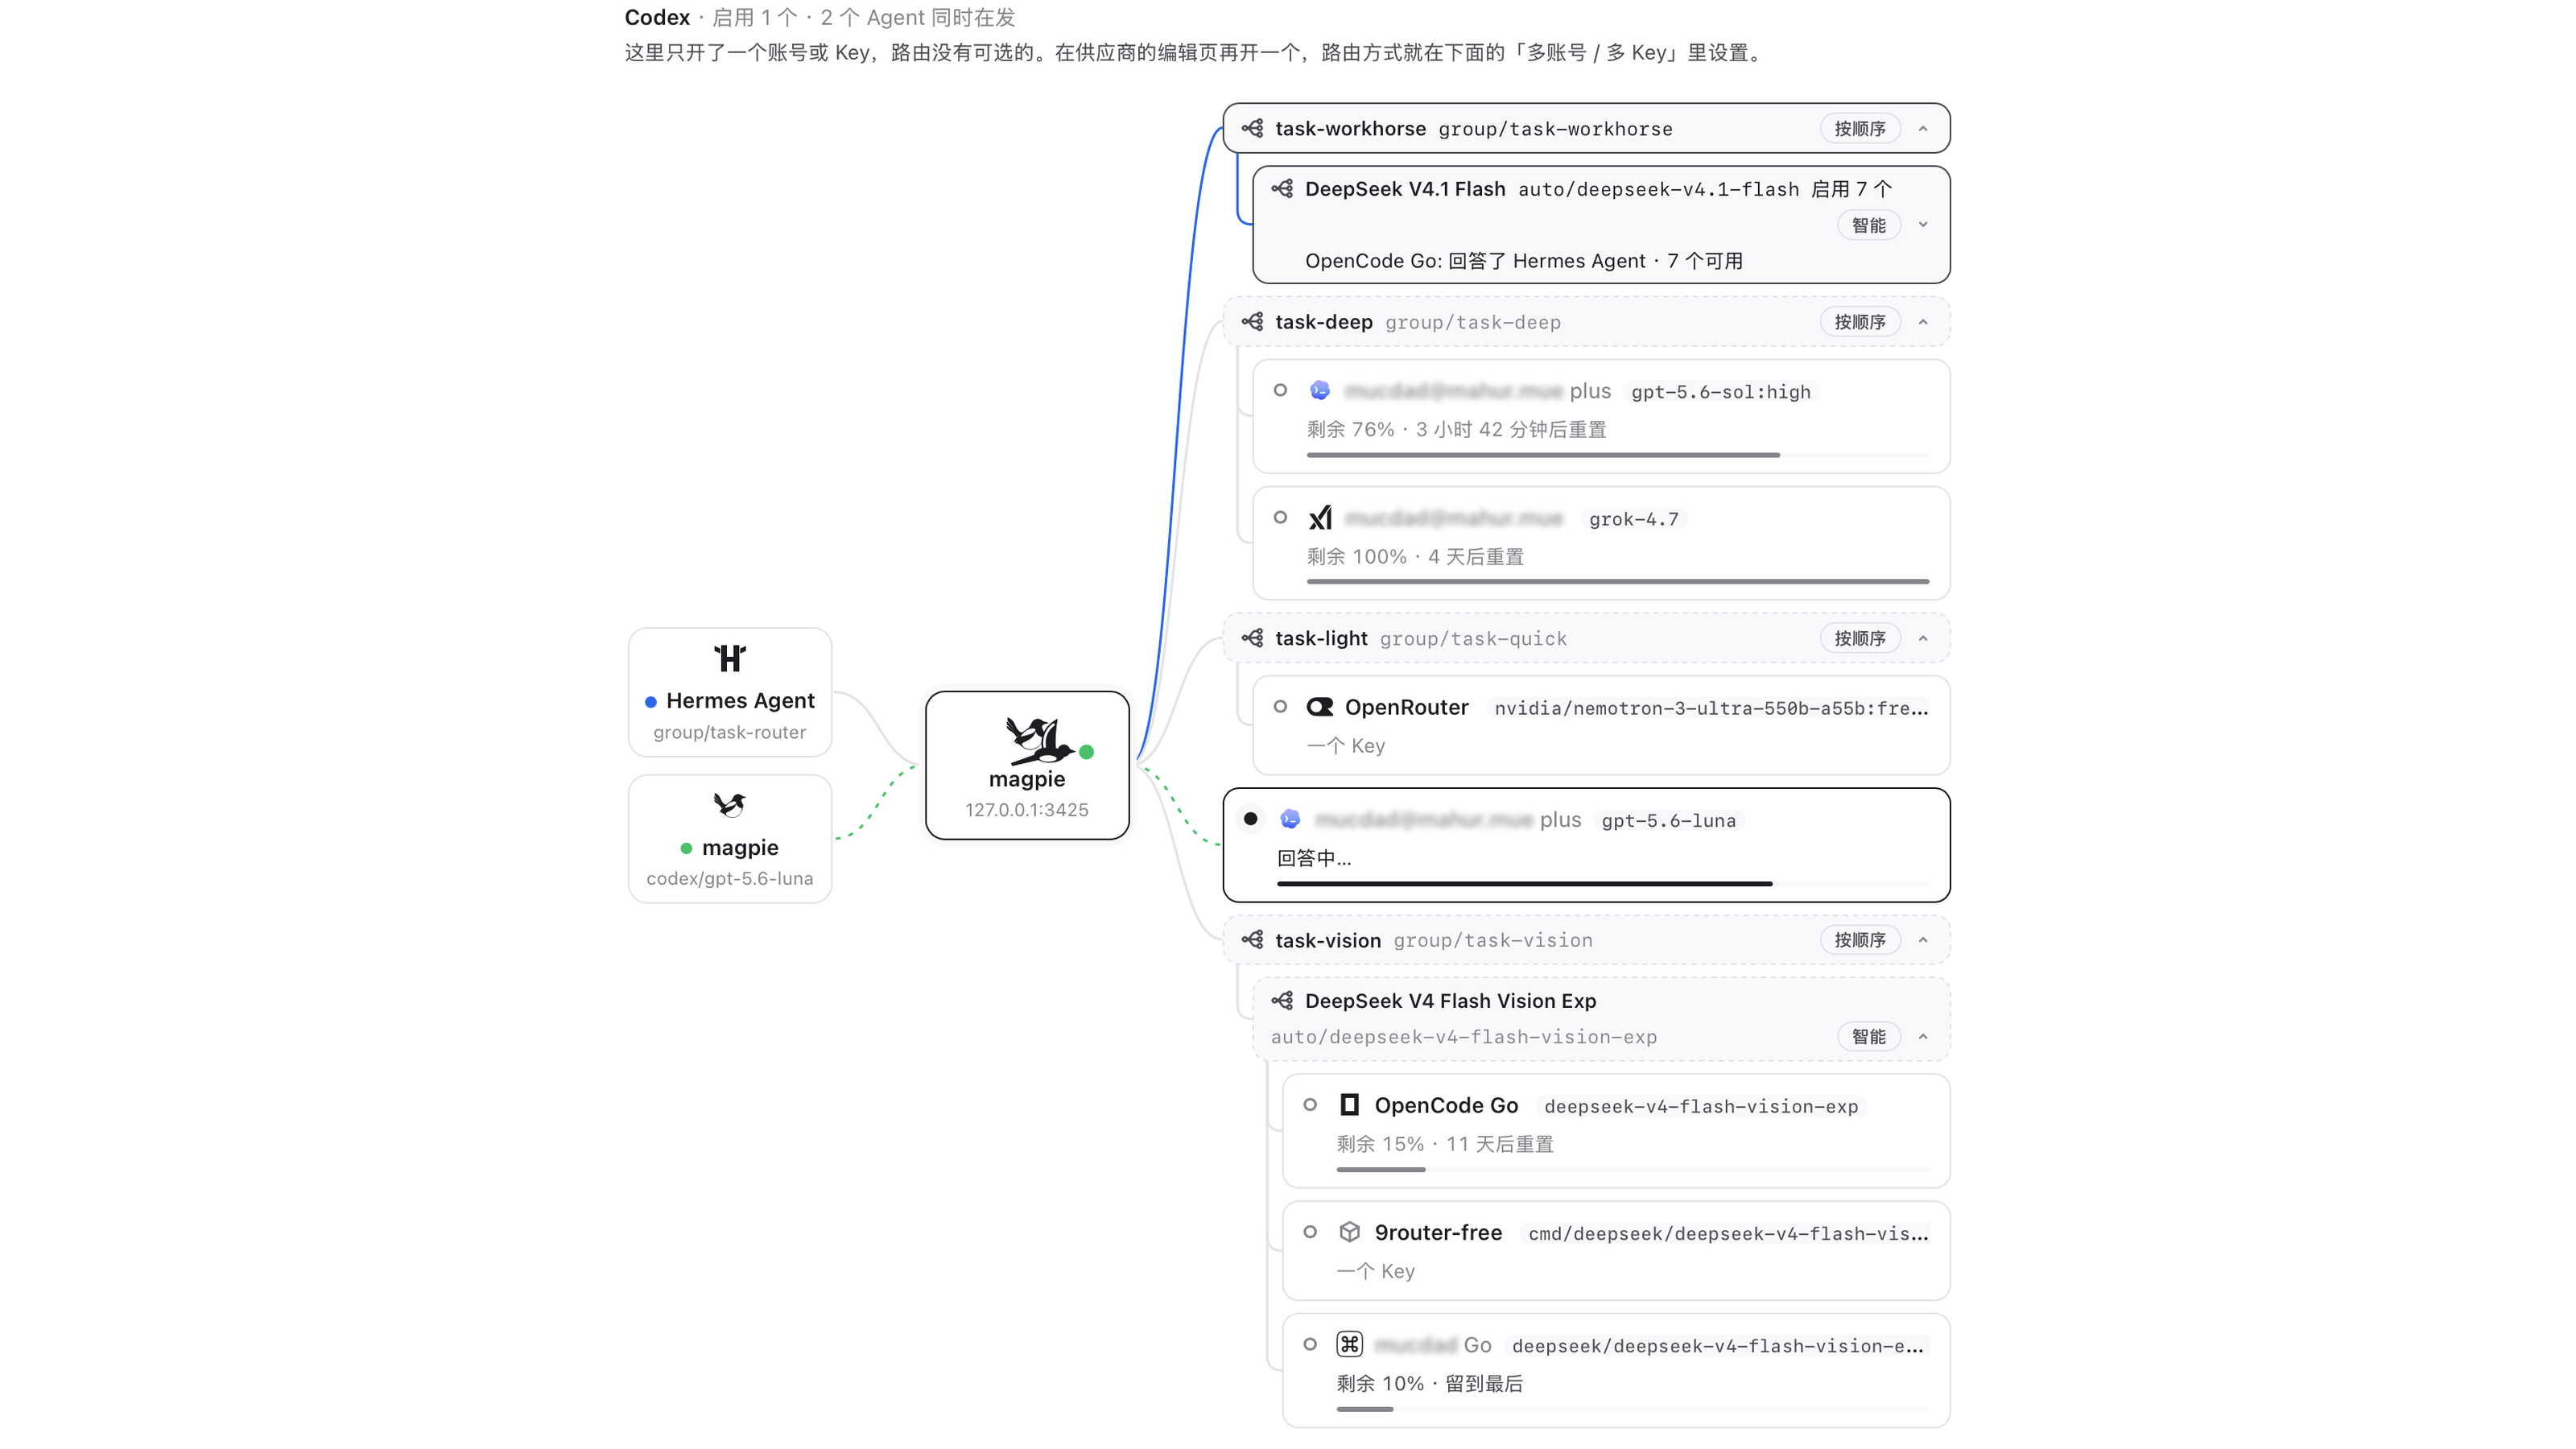
图里左边是 Hermes,它只指向中间的总组;中间那个方框叫 task-router,右边四条分支分别通向 workhorse、deep、light、vision。每个子组下面挂着它自己的模型和额度。
七条规则怎么排
规则从上往下,第一条命中的说了算:
- 会话压缩,走 workhorse
- 带图片,走 vision
- 明确要求高强度推理,走 deep
- 上下文超过 15 万 token,走 workhorse
- 架构设计、复杂规划、根因分析、高风险修改,走 deep
- 写功能、修测试、重构、常规排障,走 workhorse
- 非代码的简短问答、翻译、摘要、小改字,走 light
前四条看的是硬特征:图片有没有、上下文多长、要多少推理档。这类条件不需要模型猜,判断又快又稳。
后三条需要理解用户想干什么,交给一个分类模型。它只负责判路,不负责干活。
顺序有讲究。压缩和图片必须排最前面,否则一张图会被后面的意图规则抢走。长度规则要排在推理档之后,这样一句“认真想想”依然能进深度组。
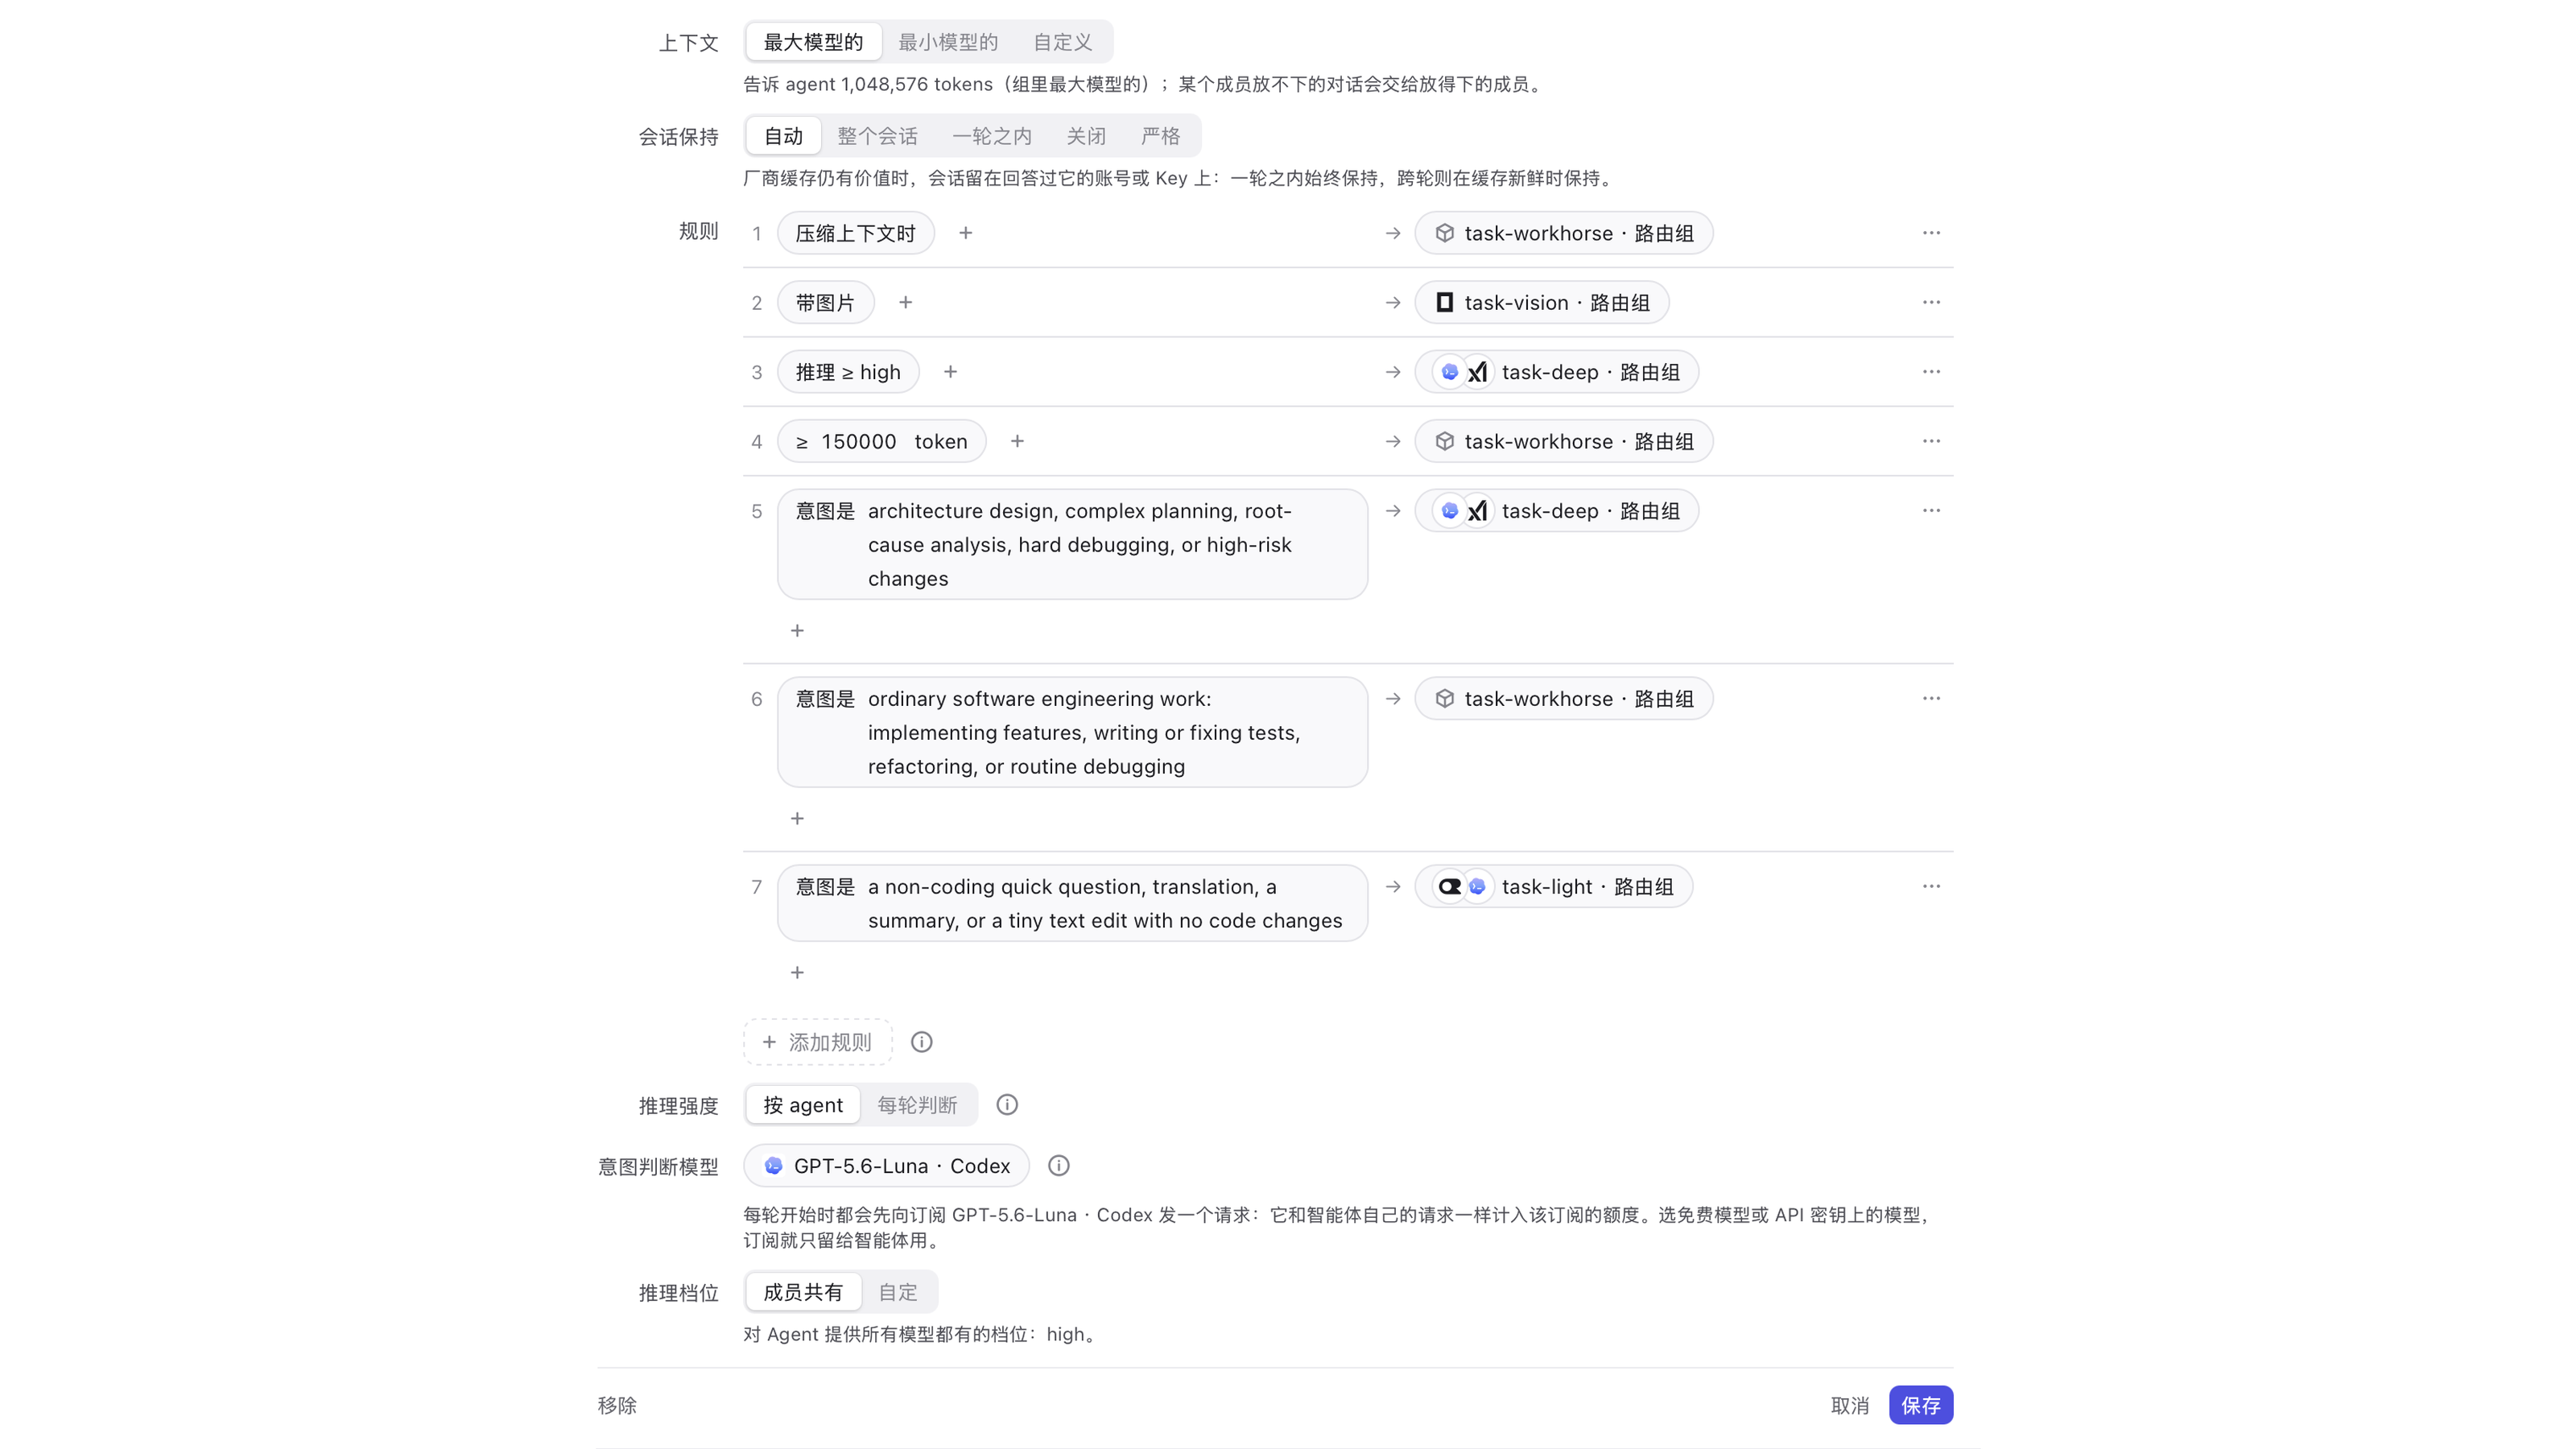
界面上规则是可以用鼠标上下拖的。前四条用现成的条件(压缩、图片、推理档、token 数),后三条得自己写一句英文描述。
没有规则命中时,请求按总组的默认顺序进入 workhorse。普通任务不会误占高推理额度。
一步步配出来
下面是完整命令。组名可以换成你自己的,注意别和已有组重名。
第一步,建三个子组。
1 | magpie group add light \ |
routing=order 是按顺序走:先用第一个,不行再试下一个。这是最直观的一种,适合组内模型能力有明确高下的时候。
模型名用 magpie models 里列出来的原样写。group/xxx 这种写法表示把一个现成的模型组嵌进来,适合同一个模型有多个供应商入口的情况。
第二步,建图片组。
1 | magpie group add vision \ |
视觉模型单独成组的好处是额度分开算,文本任务再忙也不会挤掉看图的能力。
第三步,建总组,把子组放进去。
1 | magpie group add task-router \ |
顺序就是兜底顺序。规则没命中的请求会按这个顺序走,所以把日常主力放在第一位。
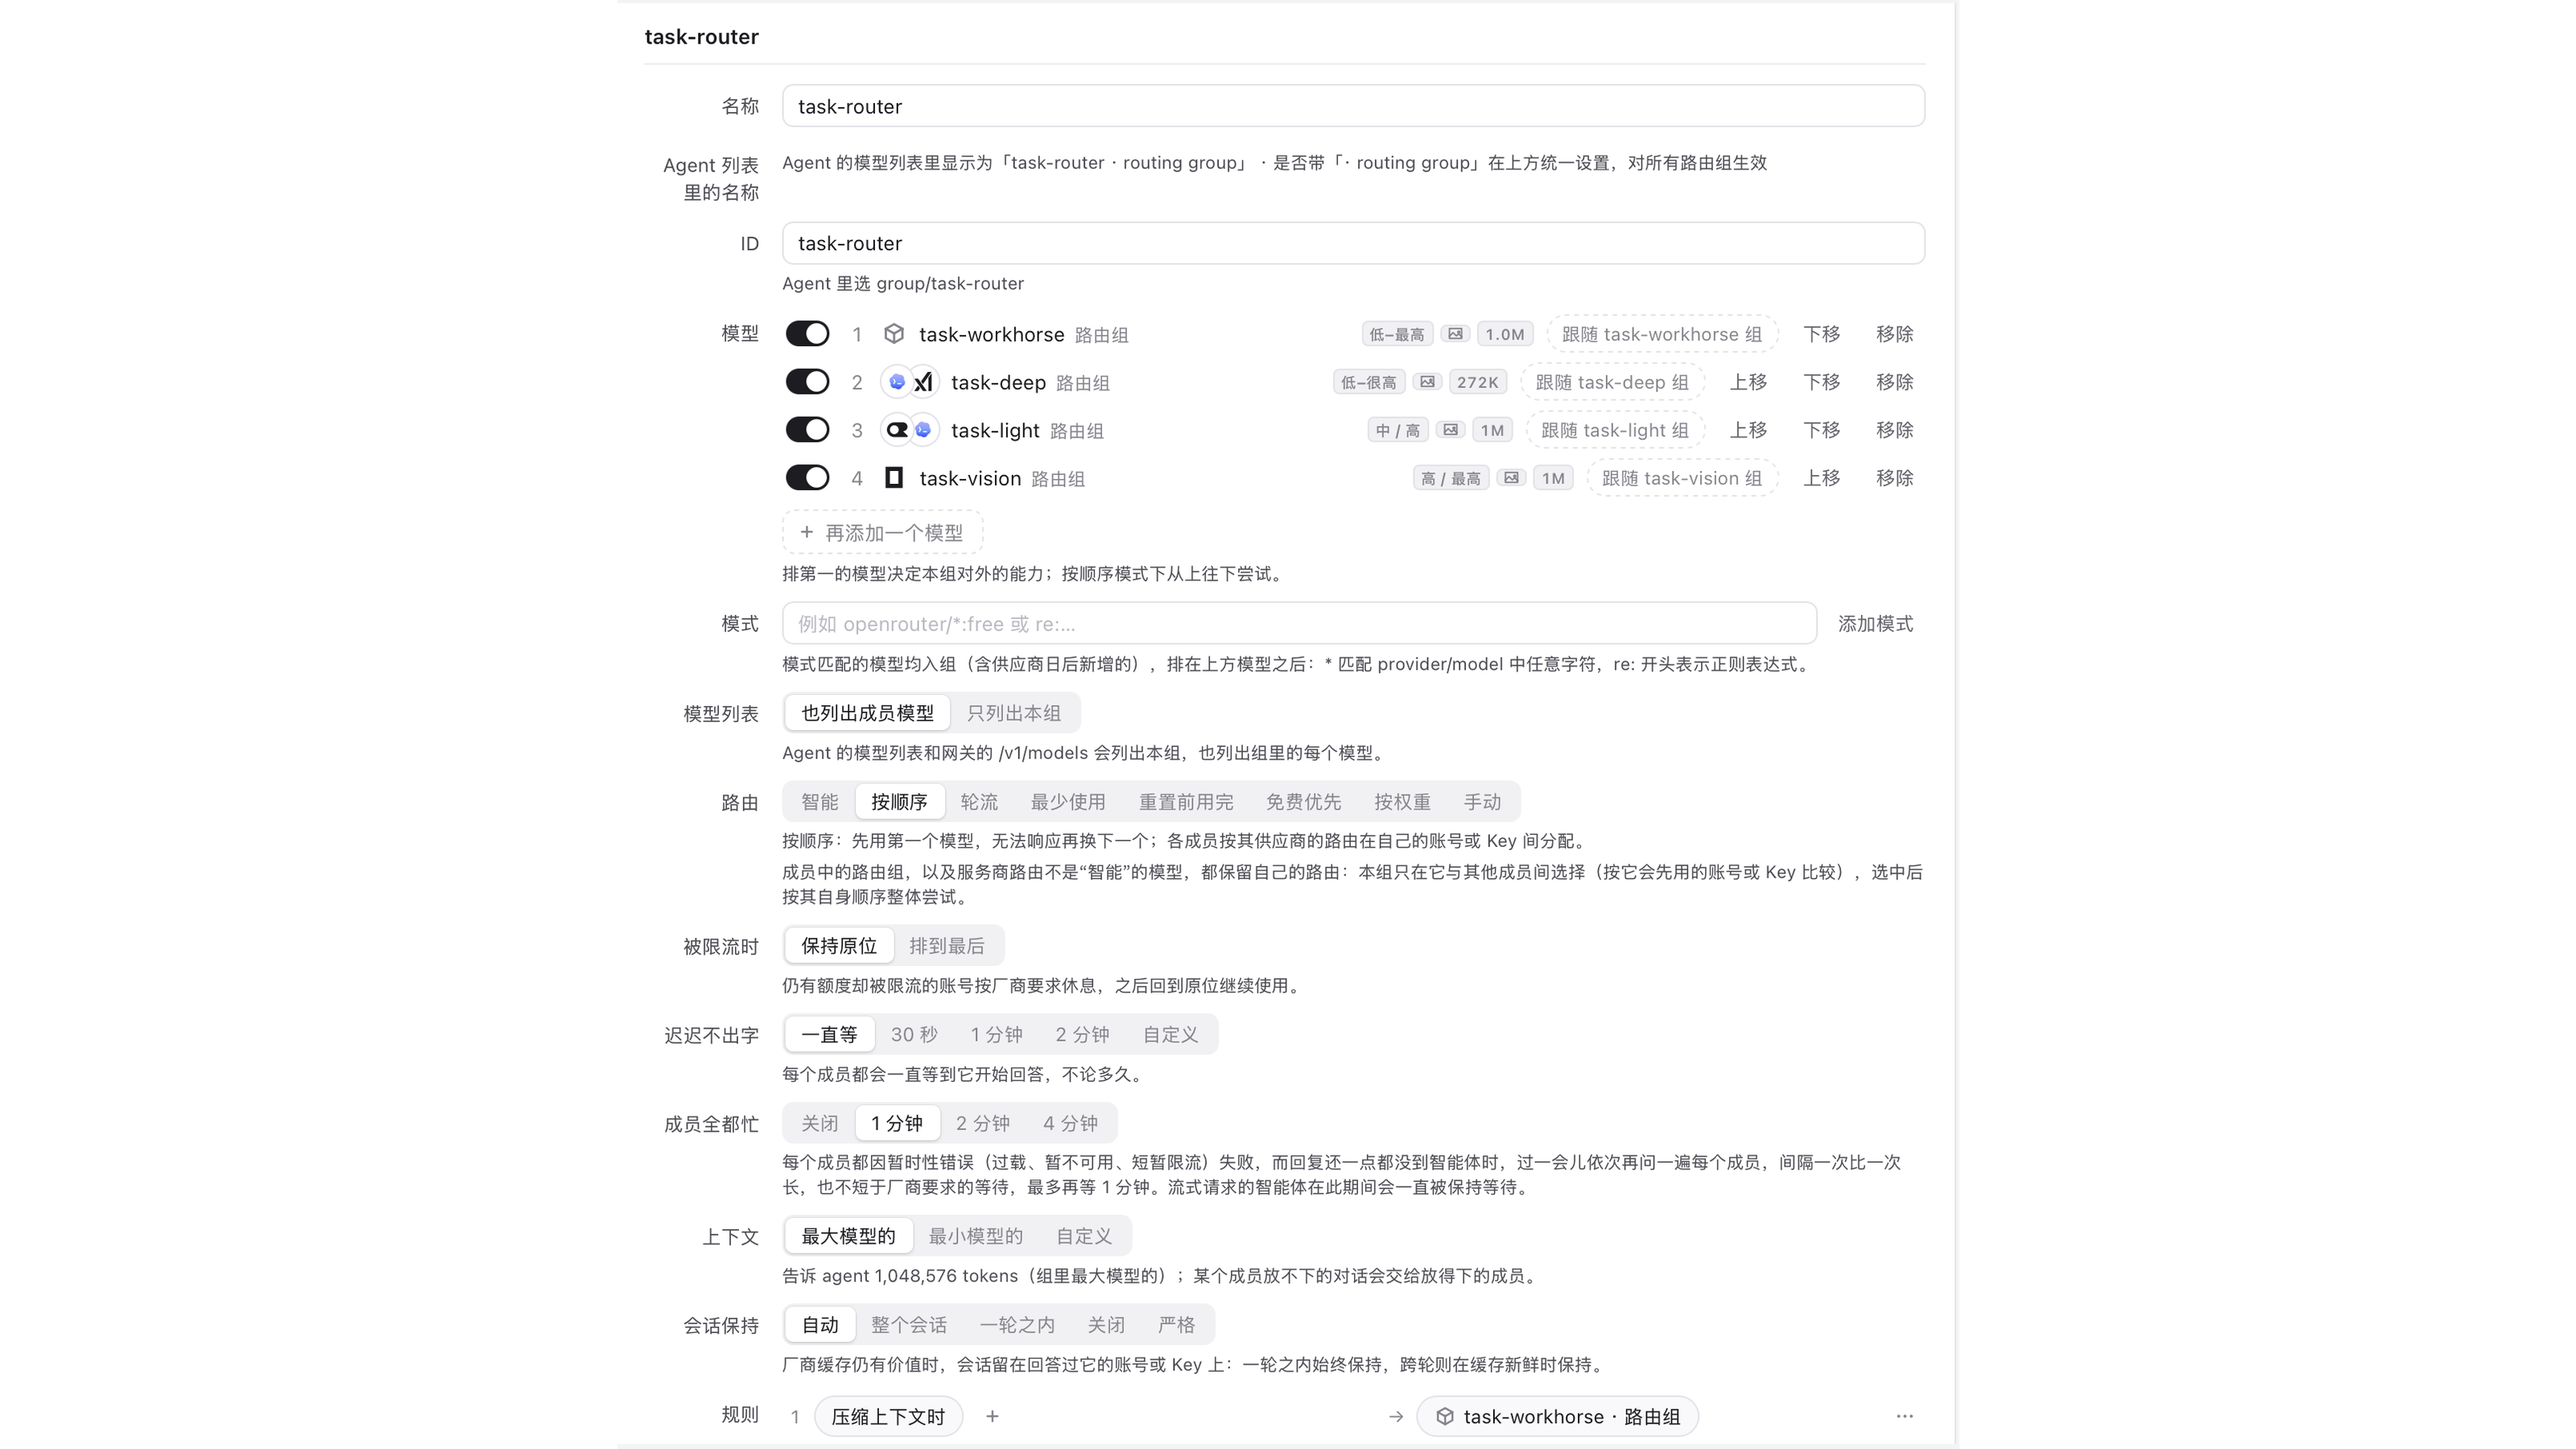
这张是同一个组的设置面板。四个成员标着序号,右边的下拉框能改顺序;每个成员旁边写着它能接的上下文长度和推理档。下面还有“模式”“被限流时”“迟迟不出字”这些选项,各有默认值,多数情况不用动。
第四步,加规则。
1 | magpie group rule add task-router use=group/workhorse compact |
这四条都是硬条件,一条命令一条规则。
compact 表示会话压缩,images 表示请求里带图,effort=high 表示智能体明确要了高强度推理,tokens=150k 表示上下文超过十五万 token。
第五步,加三条意图规则。
1 | magpie group rule add task-router use=group/deep \ |
intent 用英文写自己的话,写多细都行。写得越具体,分类越准。我这里把三类活分别写成了一段描述,而不是一个词。
第六步,指定分类模型。
1 | magpie group set task-router classifier=codex/gpt-5.6-luna |
分类模型挑小的、快的、不带推理的就行。它的活只是判断这句话属于哪一类,不需要写答案。
第七步,把智能体的默认模型指过来。
1 | magpie hermes group/task-router |
hermes 换成你实际用的客户端名。到这一步就生效了,不用重启。
配完怎么确认生效
先看结构对不对:
1 | magpie group task-router |
会列出成员、七条规则、分类模型,以及哪几个客户端在用。规则编号和顺序都在这张表里,对着核一遍。
再用一句小问题试:
1 | curl -s http://127.0.0.1:3425/v1/chat/completions \ |
返回正常就说明总组通了。
最后查日志,看它究竟走了哪条规则:
1 | tail -n 5 ~/.config/magpie/routing/$(date +%F).jsonl | jq '{time, rule: .rule.use, served}' |
rule.use 是命中的子组,served 是实际回答的模型。两个都对,说明这一路已经通了。
列表里偶尔会出现 rule 为空的行,那是分类模型自己那次判断的调用记录,不是业务请求,忽略即可。
实测效果
配完当晚跑了两百多条请求,全部走这一个入口。
分流结果:
| 去了哪 | 请求数 |
|---|---|
| workhorse | 90 |
| light | 45 |
| 走默认顺序 | 45 |
| deep | 32 |
| vision | 4 |
两百多条里只有两条是被智能体自己取消的(我中途打断了请求),其余全部成功返回。
那 45 条“走默认顺序”不是漏判。同一轮对话里后续的请求会沿用已经定好的路线,分类只在每轮开头做一次,一次定一路。这本身就省了一层开销。
长上下文这条路效果最明显:当晚有 29 条请求带着十六万到二十三万 token 的上下文,全部自动落到了主力组,没有一条挤进轻量组。轻量组处理过的最长请求停在八万六千 token。
图片三张测试图,全部命中视觉组,识别结果都对:小字卡片上的五行文字、批次号、色块颜色一个不差;模拟的任务面板认出了三个任务标题和三个状态标签;一张风景图把房子、树、路、山、太阳都点到了。
延迟方面,同一个短问题,轻量组中位数 5.2 秒,主力组 2.8 秒。轻量组的价值在省额度,不在抢速度;要快要稳就走主力组,这个分工在配置里是能自己调的。
想改的时候改哪里
换模型:magpie group set <子组> models=<新模型列表>。只影响那一路。
调长度门槛:把第 4 条规则删掉重加,tokens=200k 就是二十万。
调整兜底顺序:magpie group set task-router models=group/light,group/workhorse,group/deep,group/vision。
看某条规则什么时候触发:查日志里的 rule.n,就是规则编号,对回 magpie group task-router 的表就能读明白。
临时停掉某条规则:magpie group rule rm task-router <编号>。删之前先记下编号,加回来时用同样一条 add 命令。
结论
这套配置做的是把“选模型”从每次对话的临时决定,变成一次配好、长期生效的固定分工。
普通活交给普通模型,难活留给强模型,长上下文和图片各走专门的路,首选不可用时组内自动接续。
七条规则配一次,之后不用再记哪个模型配哪种活。这大概是它最省心的地方。