Mac mini6 32G 上 Qwen3.8 27B 完成 Pi 子任务能力实测
摘要
这次测试要回答一个具体问题:mini6 上的 qwen3.8:27b-mlx 能否在上级智能体拆解任务后,借助最少的 Pi 工具完成有边界的工作?八项有效用例覆盖计算、文档提取、代码诊断、临时文件修改、图表理解、中文 OCR 和表格读数,均达到预设答案;单次墙钟耗时为 10.08–35.92 秒。另有一次故意保留的接入失败:Pi 模型目录未声明图像输入时,模型根本没有收到图片,不能把那次猜错归因于视觉能力。
结论限于这批短任务:它可以承担受控子任务,由上级智能体决定工具、提供上下文并验收结果。复杂多文件工作、长期自主规划、真实拍照文档及手写 OCR 尚未由本次测试证明。
测试环境与计时口径
推理设备:mini6,M6、32 GB 统一内存;Ollama 模型
qwen3.8:27b-mlx,MLX runner。调用端:本机 mini4,Pi 1.2.0,经已配置的 Ollama OpenAI 兼容接口访问 mini6。
可见过程:Herdr
wx工作区的测试泳道w2F:p2,各用例串行执行。统一关闭 Pi 扩展、MCP、技能、提示模板和项目上下文文件;每项使用独立的
--no-session单轮请求,并设置--thinking off。耗时由
/usr/bin/time -p的real记录,包含 Pi 启动、请求和生成答案;不包含准备测试图及人工核对。每题仅测一次,未控制模型冷热状态或其他设备负载,数字不能视为稳定延迟或吞吐量基准。
调用骨架如下;<工具>按题目替换为 --no-tools 或 --tools read 等,图片用 @图片路径作为附件传入:
1 | /usr/bin/time -p pi --provider ollama --model qwen3.8:27b-mlx \ |
--no-context-files 会跳过项目指令文件。因此分派真实工作时,必须由上级智能体把相关约束写入指令,或有选择地加载必要上下文。
一、文本与工具任务
| 用例 | 给 Pi 的工具 | 题目与预期 | 实际结果 | real |
|---|---|---|---|---|
| 定量推理 | --no-tools |
甲车 60 km/h 先行 35 分钟,乙车 90 km/h 同向追赶;问乙车出发后几分钟追上。标准答案:70 分钟。 | 仅输出 70,正确。 |
10.88 秒 |
| 文档提取 | --tools read |
读取现有的 Hermes 本地模型测试记录,提取 Qwen 的正确率、平均每题耗时、工具题耗时及每轮预填充量。 | 6/6、63 秒、60 秒、约 3.2 万 token,均与源文一致。 |
17.41 秒 |
| 代码诊断 | --tools read,bash |
检查 primes.py 的 sieve(0),要求最小复现、解释原因与修法,不修改文件。 |
正确指出长度为 1 的列表被写入索引 1,抛出 IndexError;建议在 limit < 2 时提前返回 []。 |
35.92 秒 |
| 小范围修改 | --tools read,edit |
只修改 /tmp 中的 primes.py 副本,使 limit < 2 返回空列表。 |
仅在函数开头增加两行守卫;原项目文件未改。 | 25.22 秒 |
修改结果另做了独立检查:副本与原文件的 diff 只有 if limit < 2: return [] 两行;sieve(0)、sieve(1) 返回 [],sieve(2) 返回 [2],sieve(10) 返回 [2, 3, 5, 7],1000 以内仍有 168 个素数。代码诊断题的最终答案称已运行复现,但本次没有保存结构化工具调用日志,因此该题的评价依据是诊断内容与源代码、独立检查一致,不对调用步骤另计分。
工具选择遵循题目所需的最低权限:纯推理无需工具;读取资料只给 read;需要执行复现才加 bash;只需改现有文件时给 read,edit,不必顺手开放 write 或 bash。
二、视觉接入故障与修正
Ollama 的模型列表显示 qwen3.8:27b-mlx 具备 vision 能力,但本机原 Pi 模型条目只有 id。第一次将下图作为 @图片附件提问时,Pi 未把图片交给模型;模型明确说“无法查看图片”,依据文件名猜测子图项数,猜成“1、5、10、20”等,耗时 32.97 秒。这是接入配置失败,不是一个有效的识图成绩。
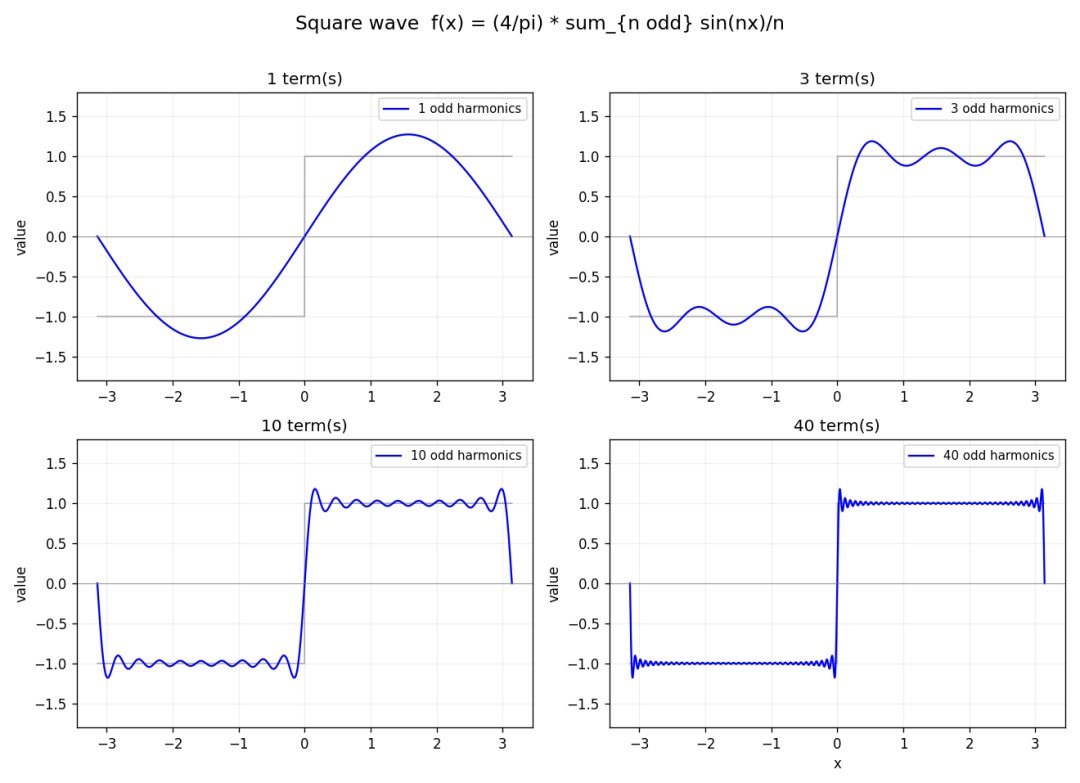
方波级数四子图
为隔离验证,在临时 Pi 配置中明确写入图像输入类型,未改动原有用户配置:
1 | { |
随后用 PI_CODING_AGENT_DIR=<独立配置目录>调用 Pi。四项视觉任务均使用 --no-tools;图片附件不需要 read 工具。要正式复用视觉能力,应给专用 Pi 配置或主模型条目加入 "input": ["text", "image"],并用一张已知答案的图片验证实际送达。
三、识图与 OCR 用例
| 用例 | 标准答案与判定点 | 实际结果 | real |
|---|---|---|---|
| 图表理解 | 四幅子图分别是 1、3、10、40 项;蓝线逐步逼近方波,跳变处有过冲/振荡(吉布斯现象)。 | 三个判定点均正确。 | 19.49 秒 |
| 清晰中文记录 OCR | 逐行转写标题、送检单位、编号、日期、温湿度、结论和验证码,共 7 行。 | 7 行的文字和关键字符均正确;仅空格数量不作为错误。 | 15.45 秒 |
| 表格 OCR 与计算 | 四行零件、编号、实测值和判定;找出不合格件,计算合格件实测值均值。 | 四行均正确;不合格编号 LN-106;(99.6+98.7+101.4)/3=99.9%,正确。 |
23.67 秒 |
| 轻度退化图片 OCR | 将同一记录缩至 850×425,旋转 2.2°、轻微模糊,再以 JPEG 55 质量保存;仍逐行转写。 | 7 行及编号、验证码、温湿度均正确。 | 10.08 秒 |
OCR 测试图使用虚构内容,不对应任何真实单位或业务记录。图片及标准答案保存在本文旁边,便于人工复核。
中文混排记录
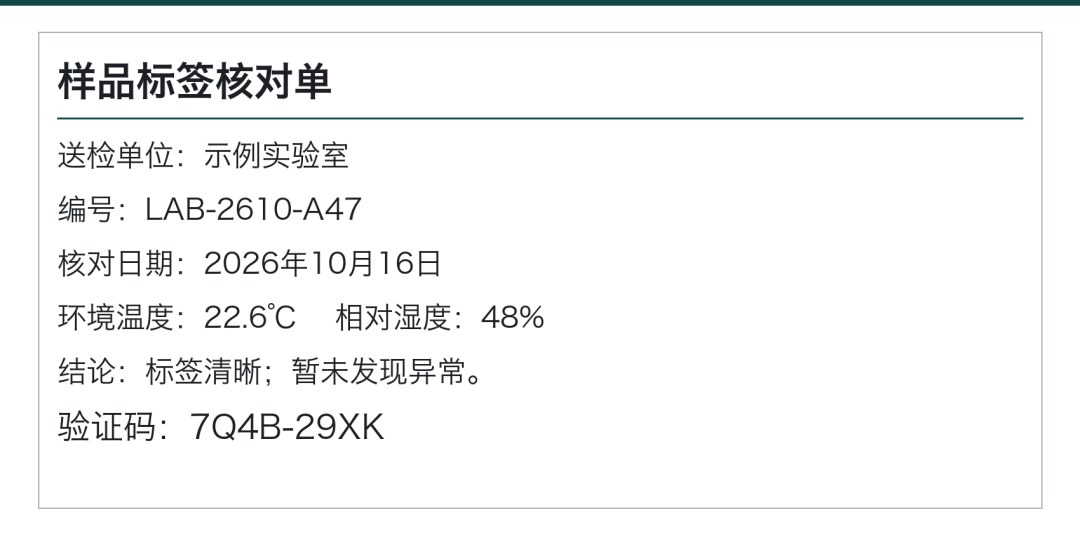
清晰中文记录
标准答案:
1 | 样品标签核对单 |
轻度退化版本:
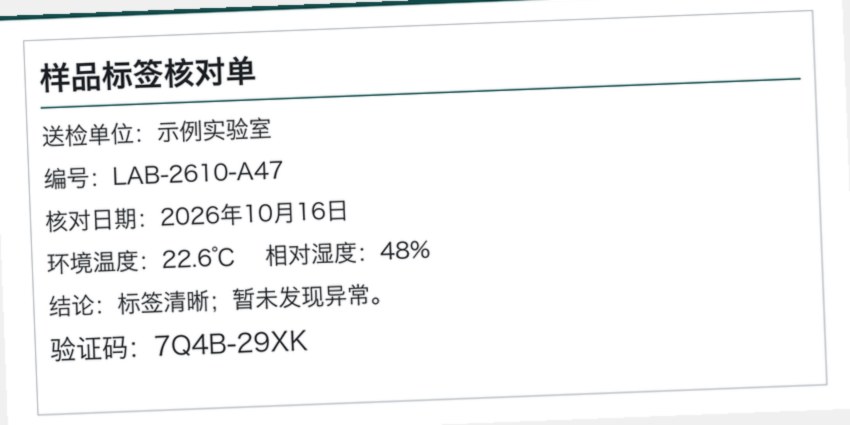
缩小倾斜并压缩后的记录
表格读取和基于图片的计算
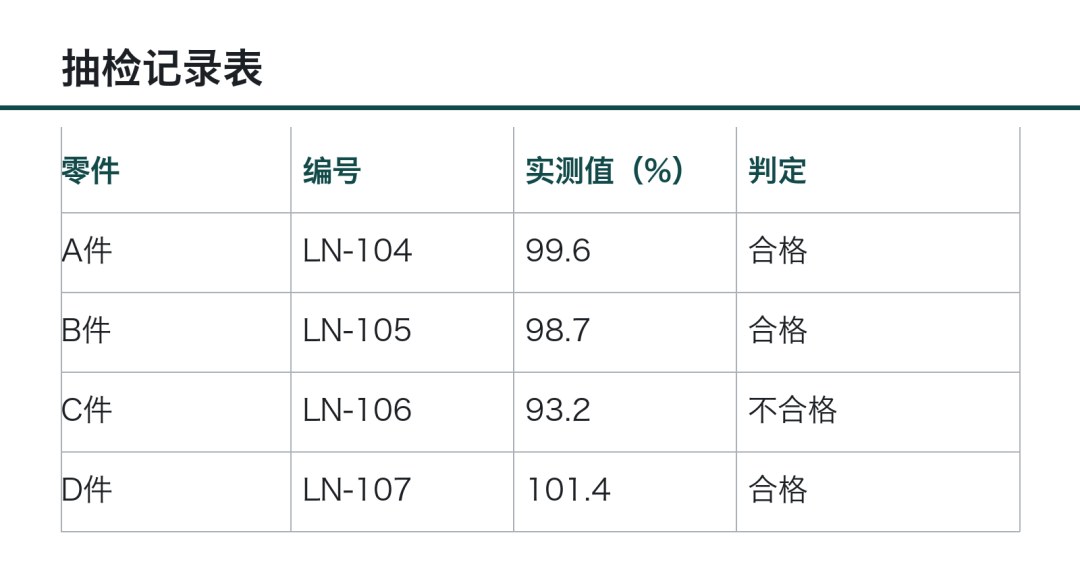
抽检记录表
| 零件 | 编号 | 实测值(%) | 判定 |
|---|---|---|---|
| A件 | LN-104 | 99.6 | 合格 |
| B件 | LN-105 | 98.7 | 合格 |
| C件 | LN-106 | 93.2 | 不合格 |
| D件 | LN-107 | 101.4 | 合格 |
四、结论与使用方式
可以作为受控子智能体。 八项有效短任务均得到正确结果,包括一次真正修改临时文件且经独立检查通过。上级智能体适合把界限清楚的计算、资料提取、代码局部诊断与修改、清晰图片识读及印刷体 OCR 交给它,并负责验收、合并和最终决策。它也确实能在精简 Pi 中运行;问题是重配置下的提示词和工具负担,以及复杂长任务尚未得到本次验证,不能概括为“完全不能跑 Pi”。
暂不据此放手长期独立执行。 本次只有单轮或少数工具调用,没有测试复杂多文件修改、长会话上下文累积、失败恢复、真实手机照片、手写字或密集小字。涉及金额和关键编号时,OCR 输出仍应与原图或其他来源复核。
分派原则:先选任务,再选工具;默认零工具,按需添加 read、edit、bash。把输入控制在相关片段内,给出明确交付格式与完成条件,结果由上级智能体验收。视觉任务还必须确认模型目录声明了图像输入,并在首次使用时用已知图片做送达检查。
与此前重配置测试的关系
此前 Hermes 或插件较多的 Pi 测试曾出现长提示词、首字等待和超时。本次精简方案的短任务在 10–36 秒内完成,说明Agent 包装层的固定开销会显著影响可用性;但两批测试的任务、模型缓存和运行环境没有严格配平,不能用这两组墙钟时间计算精确加速倍数,也不能据此宣称长任务性能问题已经消失。
可复核材料
Herdr 泳道:
wx / w2F:p2,保留了每条调用的终端输出与real计时。本文附带四张实测图片;其中方波图来自
wx项目,其余图片为本次生成的虚构测试材料。文本任务分别引用
wx项目中的 Hermes 测试记录和primes.py;修改只发生在临时副本,原项目未更动。本次没有多次重复取均值、没有固定模型缓存状态,也没有留存结构化 Pi 工具事件日志;上述结论仅覆盖已列出的测试条件。